
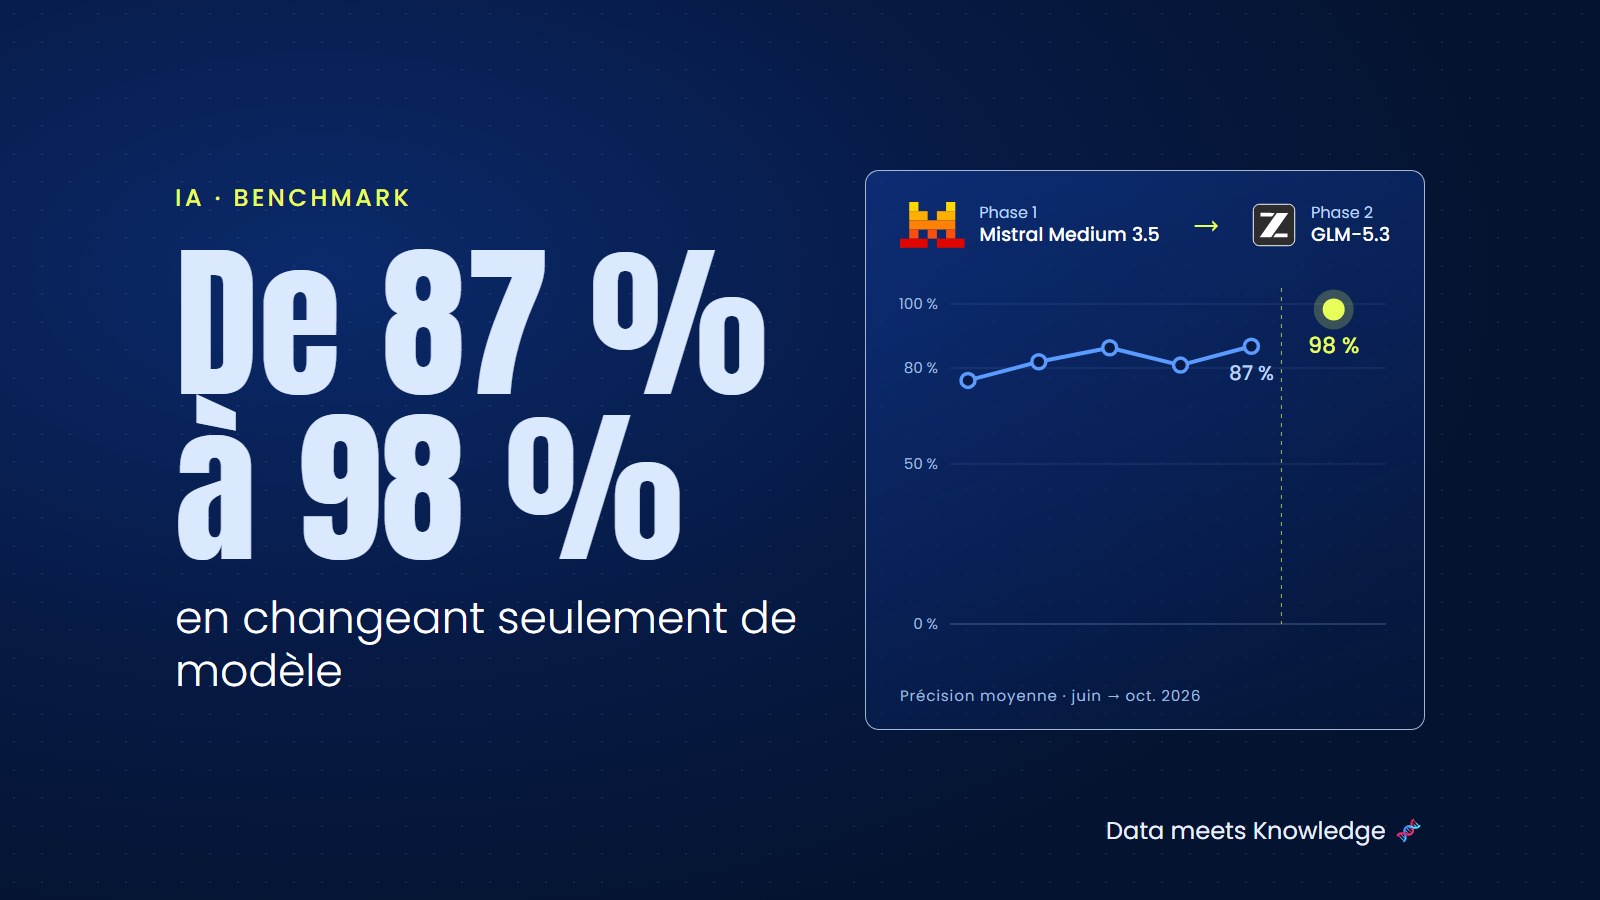
Pendant quatre mois, nous avons amélioré tout ce qui entoure le modèle d'IA : l'ontologie, la couche sémantique, le harnais agentique. La précision a grimpé, puis elle a cessé de grimper. En octobre, nous avons changé une seule pièce : le modèle. Voici ce que racontent les chiffres.
Cet article suit le fil d'une expérience menée en conditions réelles, mesurée chaque nuit sur les mêmes questions métier. Deux phases, une même méthode, et une leçon qui dépasse notre cas : une bonne architecture fait progresser l'IA jusqu'à un certain point, puis c'est la capacité du modèle qui fixe la limite.
Nous n'avons changé qu'une seule pièce. La précision est passée de 87 % à 98 %.
Le contexte : un graphe, une ontologie et un agent
Graphicient relie les données d'ingénierie et de fabrication dans un graphe de connaissance, guidé par une ontologie. Au-dessus, un agent conversationnel répond aux questions des métiers en langage naturel : « quels véhicules utilisent cette pièce ? », « combien de références de batterie sont montées sur les véhicules produits en Inde ? ».
Le terrain est exigeant : la nomenclature (BoM) d'un grand constructeur automobile. Plus de 10 millions d'objets reliés, jusqu'à 15 niveaux d'imbrication dans une nomenclature, et environ 1 400 termes et synonymes métier dans l'ontologie. Ici, une réponse plausible ne suffit pas : un chiffre approximatif est un chiffre faux.
L'agent ne travaille jamais seul. Quatre briques l'entourent, et chacune a été construite pour corriger un échec mesuré.
Le problème : un plafond que l'architecture ne perçait plus
De fin juin à début octobre, le modèle au cœur de l'agent était Mistral Medium 3.5. Un modèle efficace, rapide et économique, que nous avons entouré de toute notre attention.
- Une ontologie enrichie et une couche sémantique : les mots des métiers retrouvent les bons concepts. Lors de notre test de septembre, 24 concepts métier sur 24 étaient trouvés au premier rang.
- Un harnais agentique plus solide : une quinzaine de corrections et de vérifications automatiques sur chaque requête, des outils exécutés en parallèle, des savoir-faire écrits par les métiers eux-mêmes. Sur les questions difficiles, les requêtes en erreur sont passées de 44 % à 7 %.
- Une mémoire maîtrisée : le modèle reçoit un briefing précis et stable plutôt que des données brutes. L'essentiel est servi depuis le cache, ce qui rend chaque réponse plus rapide et moins coûteuse.
Les résultats ont suivi. La précision est passée d'environ 76 % fin juin à 87 % début octobre. Le temps moyen par question a été divisé par trois, d'environ 110 s à 37 s, et la consommation de jetons a baissé d'un tiers.
Puis la courbe s'est aplatie : évaluation après évaluation, la précision plafonnait autour de 87 %. Chaque nouvelle règle corrigeait une question… et en fragilisait une autre.
Le harnais ne pouvait plus compenser ce que le modèle ne savait pas faire.
Les erreurs restantes avaient un point commun. Elles demandaient de tenir un raisonnement long sans perdre le fil : enchaîner plusieurs niveaux de nomenclature, croiser deux ensembles, respecter une consigne métier jusqu'au bout. Le modèle sautait une étape de la méthode, ou oubliait une règle en cours de route. Sur l'Intelligence Index d'Artificial Analysis, une évaluation indépendante de la capacité de raisonnement des modèles, Mistral Medium 3.5 obtient 14 points [1].
La preuve : mesurer chaque nuit, sur les mêmes questions
Pour distinguer un vrai progrès d'une impression, nous évaluons l'agent complet, pas le modèle seul, sur un jeu de questions de référence. La méthode n'a pas changé entre les deux phases.
Deux évaluations identiques peuvent varier de 3 à 5 points : nous lisons des tendances, pas des scores isolés. La phase 1 se lit comme une montée régulière jusqu'à un palier. La phase 2 se lit comme un changement de niveau.
Le twist : un nouveau modèle, et tout le reste à l'identique
Mi-octobre, un nouveau modèle devient disponible dans notre environnement : GLM-5.3, un modèle à poids ouverts publié par Z.ai en août 2026. Sur le même Intelligence Index, il obtient 34 points dans son réglage le plus économe, « effort low », contre 14 pour Mistral Medium 3.5 [1].
 GLM-5.3 · effort max45
 Mistral Large 4 Preview38GLM-5.3 · effort low (phase 2)34Mistral Medium 3.5 (phase 1)14
Nous l'avons branché tel quel. Même ontologie, mêmes outils, mêmes consignes, mêmes 98 questions, même juge. Les deux modèles sont ensuite passés le même jour, l'un après l'autre, sur le même jeu de questions.
Mistral Medium 3.5GLM-5.3 (effort low)Et le résultat s'est confirmé sur les évaluations suivantes : 98 % de réponses justes en moyenne.
Plus juste, et plus rapide. Avec un raisonnement court (« effort low »), le modèle fait moins d'allers-retours (3,6 étapes par question contre 4,6) et va plus droit au but. Il consomme environ un tiers de jetons en moins, pour un coût estimé en baisse d'environ 35 % par question aux prix publics [1].
Le travail sur l'ontologie et le harnais n'est pas perdu : c'est lui qui permet au nouveau modèle d'atteindre 98 % dès le premier jour.
C'est la leçon la plus importante de cette expérience. Le modèle est une pièce interchangeable ; la connaissance structurée, elle, reste. Le jour où un modèle plus capable arrive, il bénéficie immédiatement de tout ce qui a été construit autour de lui.
La perspective : un benchmark à réinventer
À 98 %, notre jeu de référence ne fait plus la différence. Un test que l'on réussit presque parfaitement mesure surtout ce que l'on sait déjà faire. La prochaine étape consiste donc à monter en complexité.
- Des questions plus difficiles : analyses en plusieurs étapes, croisements entre la nomenclature d'ingénierie et celle de fabrication, calculs sur de grands volumes.
- Des contrôles plus exigeants : vérifier la cohérence des réponses entre elles et avec les règles métier, et pas seulement le bon chiffre.
- Des questions ambiguës : vérifier que l'agent sait demander une précision plutôt que deviner.
Un benchmark n'est pas un trophée. C'est un instrument, et il doit rester plus exigeant que le système qu'il mesure.
La vision : un agent qui peut porter davantage
Un modèle plus capable ne sert pas seulement à mieux répondre aux mêmes questions. Il permet de confier davantage à l'agent : des tâches plus longues, plus d'outils utilisés en parallèle, des analyses calculées plutôt qu'estimées.
Notre conviction reste la même : la valeur durable est dans la connaissance structurée et dans les garde-fous qui l'entourent. Les modèles vont continuer de progresser ; une architecture bien conçue permet d'en profiter le jour même.
À vous de jouer : quelle question votre graphe ne sait-il pas encore traiter ?
Sources
- [1]Artificial Analysis — GLM-5.3 (low) vs Mistral Medium 3.5 : Intelligence Index v4.3.2 (34 contre 14), prix publics par million de jetons (entrée, sortie, cache). Consulté le 14 octobre 2026. artificialanalysis.ai
- [2]Artificial Analysis — Leaderboard des modèles : scores de l'Intelligence Index pour GLM-5.3 (max), Mistral Large 4 Preview et le meilleur modèle du classement. Consulté le 14 octobre 2026. artificialanalysis.ai/leaderboards
- [3]Graphicient — évaluations internes de l'agent sur 98 questions de référence de la nomenclature d'un grand constructeur automobile, 50 évaluations complètes retenues (sur 55 lancées) de juin à octobre 2026, tracées dans Langfuse.