
Il y a un problème que rencontre tôt ou tard n'importe quel outil qui gère des données pour plusieurs clients, plusieurs projets ou plusieurs équipes : comment isoler proprement les données de chacun, tout en réutilisant ce qui existe déjà, sans finir par tout dupliquer ?
C'est exactement le problème que nous avons rencontré chez Graphicient. La solution que nous avons construite, un mécanisme que nous appelons l'héritage des contextes, illustre un principe qui dépasse largement notre cas particulier. Voici comment ça fonctionne, pourquoi c'était nécessaire, et ce que ça change concrètement.
Le problème : des silos trop chers à dupliquer
Dans Graphicient, chaque « contexte » est un espace de travail totalement isolé. Il a ses propres nœuds (les éléments d'information), ses propres liens entre ces nœuds, et son propre contenu qui définit ce que représentent ces éléments. Cette étanchéité est volontaire : c'est elle qui garantit que les données d'un client ou d'un projet ne se mélangent jamais avec celles d'un autre.
Le problème apparaît dès qu'on veut créer une variante d'un contexte existant. Prenons un cas tiré d'un usage industriel réel : une nomenclature de fabrication à grande échelle, qui décrit pièce par pièce comment un produit complexe est assemblé. Un seul contexte de ce type peut représenter plusieurs dizaines de millions de nœuds et de liens.
Imaginons qu'une usine ait besoin d'une variante de cette nomenclature : les mêmes pièces de base, avec quelques ajustements propres à sa ligne de production. Avant l'héritage, la seule option était de dupliquer intégralement le contexte d'origine. Une approche en apparence simple, qui cachait deux problèmes sérieux.
Ce second problème ne casse rien du jour au lendemain, mais il mine sur la durée la confiance qu'on peut avoir dans ses propres données. Il fallait donc créer des variantes d'un contexte sans jamais recopier la donnée du parent. C'est ce que fait l'héritage.
La solution : voir la donnée du parent, sans jamais la copier
L'idée centrale est simple : on crée un contexte « enfant » à partir d'un contexte « parent ». Une fois ce lien créé, l'enfant voit automatiquement toutes les données de son parent, exactement comme si elles étaient les siennes, sans qu'un seul nœud ni un seul lien ne soit physiquement dupliqué.
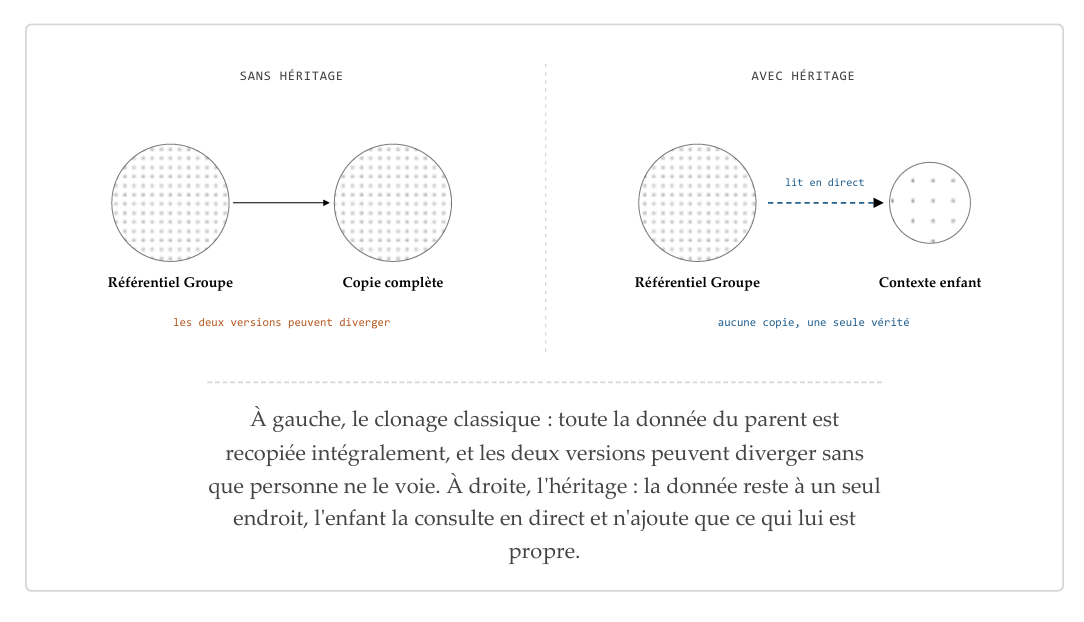
Pour reprendre notre nomenclature industrielle, l'usine crée un contexte enfant rattaché au contexte parent et à ses millions de nœuds. Ce contexte enfant a un poids de stockage quasi nul au départ : il ne contient que les quelques ajustements propres à l'usine, mais il « voit » l'intégralité des données du parent.
L'image la plus parlante est celle d'un héritage familial. Ce que possède le grand-père est vu par le père, qui peut y ajouter ses propres biens avant de transmettre le tout au fils, sans que rien ne soit jamais recopié d'une génération à l'autre.
Un contexte peut ainsi avoir un parent, qui a lui-même un parent, et ainsi de suite. À chaque instant, un contexte connaît sa lignée complète jusqu'à la racine, et c'est cette lignée entière qui détermine ce qu'il peut voir et utiliser. On construit alors de véritables arborescences de variantes : un contexte racine générique, des contextes intermédiaires par famille de produits, puis des contextes très spécifiques à un client ou une usine, chacun ne portant que ce qui lui est propre.
Deux façons d'hériter, selon le type de donnée
L'héritage ne fonctionne pas de la même façon pour les éléments du graphe (les nœuds et les liens) et pour la configuration qui les définit. Ce sont deux logiques différentes, et il valait mieux les distinguer clairement plutôt que de forcer une seule règle à couvrir les deux cas.
Les nœuds et les liens : tout s'additionne
Pour les millions d'éléments concrets qui composent le graphe, la règle est la plus simple qui soit : un contexte voit les siens, plus ceux de tous ses ancêtres. Rien ne prend le pas sur rien, tout se cumule. Interroger un contexte revient à interroger toute sa lignée à la fois et à recevoir la somme des résultats.
Le contexte de l'usine voit les millions de nœuds du parent, plus les quelques dizaines ou centaines de nœuds qu'elle a ajoutés elle-même. Aucun conflit possible : le parent apporte les siens, l'enfant ajoute les siens.
La configuration : le parent a toujours raison
Un contexte enfant embarque aussi toute la configuration de son parent : l'ontologie (les types de nœuds, leurs attributs et leur structure), les données de référence, les règles métier et jusqu'aux paramètres de confidentialité. Tout est transmis sans copie, par simple lecture à travers la lignée.
Mais la règle est ici plus stricte : un enfant ne peut jamais modifier un élément de configuration hérité, quel que soit son niveau dans la hiérarchie. Il reste libre de définir ce que personne au-dessus de lui n'a déjà défini : ses propres types de nœuds, ses propres règles, ses propres attributs. Mais dès qu'un élément existe quelque part dans sa lignée, c'est cette version-là qui s'impose.
Pourquoi ce choix ? Parce que le parent est la source de vérité pour tout ce qu'il a défini. Sans cette règle, chaque contexte pourrait maintenir sa propre version d'un même concept, ou pire, assouplir localement une règle de confidentialité posée plus haut. On retomberait exactement dans le problème de départ.
Le résultat n'est jamais figé : il est recalculé à chaque consultation. Si un parent modifie un type, une règle ou un paramètre de confidentialité, tous ses descendants voient immédiatement la modification. Il n'y a plus de copie à synchroniser, puisqu'il n'y a jamais eu de copie.
Ce que ça change concrètement
Mis bout à bout, ces mécanismes changent profondément la façon de gérer des données à grande échelle dans un système multi-contextes.
- +Un stockage maîtrisé. Créer une variante ne coûte plus la reproduction intégrale de sa donnée, seulement ce qu'elle ajoute réellement.
- +Une source unique de vérité. Plus de copies qui divergent en silence : modifier le parent met à jour instantanément tous ses descendants, sans synchronisation à déclencher.
- +Une isolation intacte. L'héritage ne casse pas le cloisonnement entre clients ou projets. Un enfant hérite des règles d'accès de son parent sans pouvoir les assouplir : un niveau de sécurité défini en amont reste valable dans tout le sous-arbre.
- +Une hiérarchie sur plusieurs générations. Un socle commun générique, des déclinaisons par famille, des variantes très spécifiques en bout de chaîne, sans jamais reproduire les niveaux supérieurs.
Les limites à connaître
Un mécanisme aussi puissant vient avec quelques garde-fous, qu'il vaut mieux avoir en tête avant de s'en servir à grande échelle.
Un exemple concret : étendre le périmètre sans jamais rompre le fil
Reprenons la nomenclature industrielle, du point de vue des utilisateurs métier qui ont besoin d'élargir ce que le graphe couvre. Le contexte racine, entretenu par une équipe centrale, décrit les pièces standard et leur ontologie de base, mais il n'a pas vocation à tout prévoir. Plutôt que d'attendre que l'équipe centrale ajoute chaque besoin au socle commun, chaque équipe métier crée son propre contexte enfant et l'étend à sa façon.
Une équipe qualité doit suivre les non-conformités constatées sur certaines pièces. Une équipe environnement veut relier chaque pièce à son empreinte carbone et à ses certifications. Aucun de ces besoins n'existe dans l'ontologie racine : ni « non-conformité », ni « certification », ni relation « impacte » ou « certifié par ».
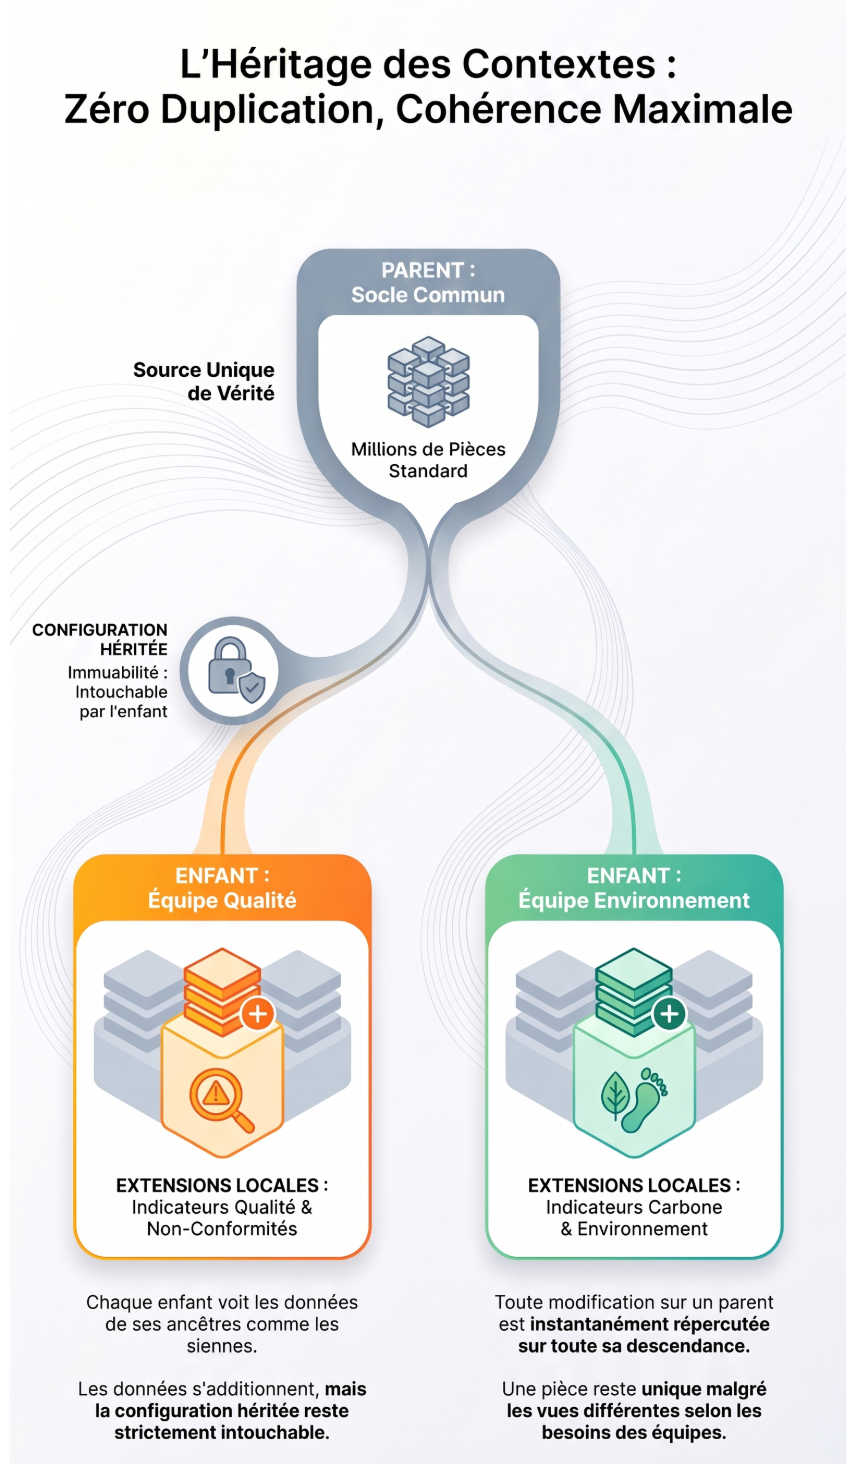
L'équipe qualité ajoute un label de nœud « Non-conformité » et un label de lien « constatée sur », qu'elle relie directement aux pièces existantes du contexte racine. L'équipe environnement fait de même avec « Certification » et « certifié par », ou « Empreinte carbone » et « impacte ». Ces labels n'existant nulle part dans leur lignée, rien n'empêche de les créer localement.
Chaque équipe étend ainsi le graphe dans sa direction, sans toucher au contexte racine et sans dupliquer les millions de pièces décrites en amont : elle vient simplement s'y raccrocher.
C'est ce qui crée une véritable continuité digitale. Une pièce reste une seule et même entité, qu'on l'observe depuis le contexte racine, celui de la qualité ou celui de l'environnement. Le jour où l'équipe centrale corrige une erreur de nomenclature, la correction se répercute partout, y compris dans les extensions de chaque équipe.
Un principe plus large qu'un cas d'usage
Ce mécanisme répond à une tension qu'on retrouve dans énormément de systèmes qui gèrent des données à plusieurs échelles : comment réutiliser ce qui existe sans le dupliquer, tout en gardant la possibilité de personnaliser localement ? La réponse apportée ici, cumuler les données factuelles mais laisser la définition des règles à la source la plus en amont, peut s'appliquer bien au-delà d'un graphe de nœuds et de liens.
Une bonne architecture de données ne consiste pas seulement à stocker de l'information, mais à décider en amont qui a le dernier mot sur quoi, et comment cette décision se propage sans intervention humaine. Logiciel multi-clients, gestion de configuration produit ou base de connaissances partagée : la question reste la même. Qu'est-ce qui doit être commun à tous, qu'est-ce qui reste propre à chacun, et que se passe-t-il le jour où l'un des deux change d'avis ?
L'héritage des contextes n'est donc pas qu'une astuce pour économiser du stockage. C'est une façon de poser, une bonne fois pour toutes, une hiérarchie claire de confiance entre les données, et de laisser cette hiérarchie faire le travail, invisiblement, à chaque consultation et à chaque nouvel usage.